


Table of Contents
- Kompetisi Red-Teaming AI: Uji Ketahanan Sistem AI Modern
- Apa Itu Red-Teaming AI dan Mengapa Penting?
- Perbedaan dengan Pengujian Biasa
- Mengapa Format Kompetisi Efektif?
- Ancaman Injeksi Prompt Tidak Langsung pada Agen AI
- Cara Kerja Serangan
- Dampak bagi Organisasi
- Strategi Pertahanan Berlapis
- Jenis Serangan yang Umum Diuji dalam Red-Teaming AI
- Jailbreak
- Kebocoran Instruksi Sistem
- Penyalahgunaan Alat dan Integrasi
- Manipulasi Bertahap dalam Percakapan Panjang
- Benchmarking Red-Teaming AI: Tantangan dan Temuan
- 7 Wawasan Penting dari Kompetisi Red-Teaming AI
- 1. Tidak Ada Model yang Sepenuhnya Kebal
- 2. Kemampuan Tinggi Tidak Menjamin Keamanan
- 3. Serangan Universal Itu Nyata
- 4. Serangan dari Model Kuat Mudah Ditransfer
- 5. Keragaman Penyerang Menghasilkan Temuan Lebih Kaya
- 6. Benchmark Komparatif Sangat Dibutuhkan
- 7. Keamanan Adalah Proses Berkelanjutan
- Kolaborasi Red-Teaming AI untuk Masa Depan Keamanan
- Peran Red-Teaming AI bagi Bisnis di Indonesia
- Melindungi Layanan Pelanggan
- Membangun Kepercayaan Pengguna
- Tantangan Red-Teaming AI dalam Konteks Bahasa Indonesia
- Langkah Praktis Menerapkan Red-Teaming AI
- Petakan Aset dan Hak Akses
- Rancang Skenario Serangan
- Libatkan Tim yang Beragam
- Dokumentasikan dan Perbaiki
- Lakukan Secara Berkala
- Pertanyaan Umum seputar Red-Teaming AI
- Siapa yang Dapat Melakukan Red-Teaming?
- Apakah Red-Teaming Berbahaya bagi Sistem?
- Seberapa Sering Pengujian Perlu Dilakukan?
- Kesimpulan: Red-Teaming AI sebagai Fondasi Kepercayaan
Kompetisi Red-Teaming AI: Uji Ketahanan Sistem AI Modern
Kompetisi red-teaming AI untuk keamanan artificial intelligence melibatkan peserta dalam merancang serangan inovatif terhadap model AI dan sistem pertahanan. Kompetisi ini menjadi alat penting untuk mengevaluasi ketahanan sistem AI modern dalam menghadapi kondisi adversarial. Baru-baru ini, Center for AI Standards and Innovation (CAISI) bekerja sama dengan sejumlah mitra. Mitra tersebut meliputi Gray Swan, UK AI Security Institute (UK AISI), serta sejumlah laboratorium AI terkemuka. Bersama-sama, mereka menerbitkan makalah penelitian berdasarkan data dari kompetisi red-teaming AI berskala besar. Penelitian ini mengungkapkan berbagai kerentanan model AI terkini dan memberikan wawasan untuk meningkatkan ketahanan sistem tersebut.
Seiring meningkatnya penggunaan agen AI dalam tugas-tugas yang melibatkan sumber data eksternal, risiko yang dihadapi juga semakin besar. Sumber data tersebut antara lain email, situs web, dan repositori kode. Salah satu ancaman signifikan adalah serangan pembajakan agen, yang dikenal sebagai injeksi prompt tidak langsung. Serangan ini dilakukan dengan menyisipkan instruksi berbahaya ke dalam data yang dikonsumsi oleh agen AI. Akibatnya, serangan ini dapat memicu tindakan berbahaya seperti kebocoran data sensitif atau eksekusi kode berbahaya. Menangani ancaman ini menjadi prioritas utama bagi CAISI dalam misinya meningkatkan keamanan sistem AI.
Apa Itu Red-Teaming AI dan Mengapa Penting?
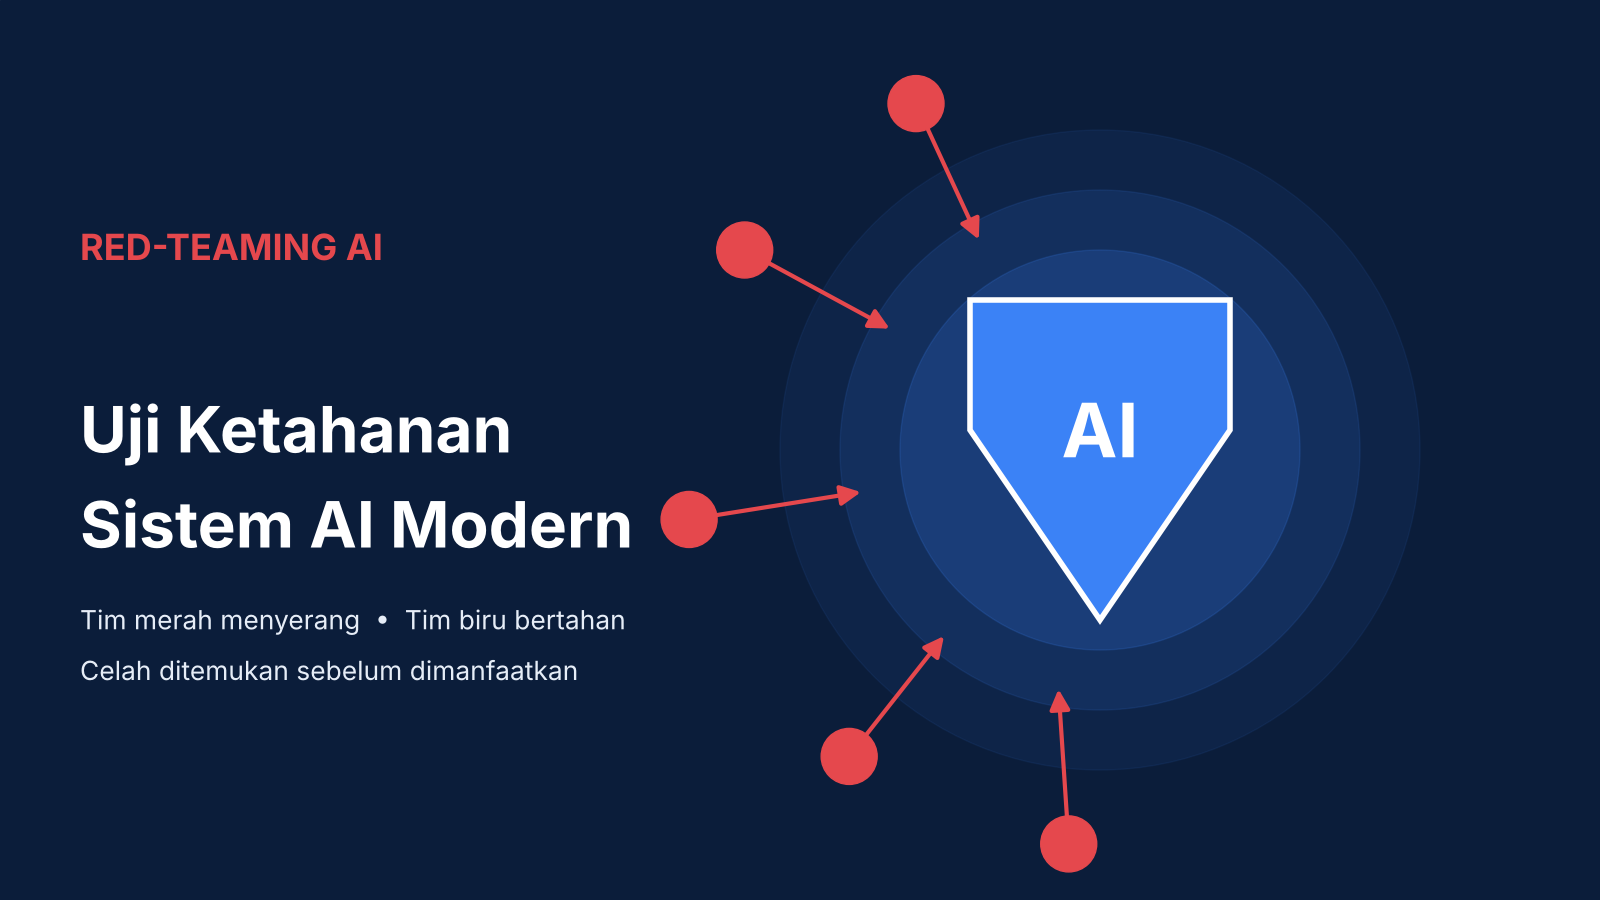
Istilah red-teaming berasal dari dunia militer dan keamanan siber. Dalam praktik tersebut, sebuah tim khusus berperan sebagai lawan untuk menguji kekuatan pertahanan sendiri. Tim ini sering disebut tim merah, sedangkan pihak yang bertahan disebut tim biru. Tujuannya bukan untuk merusak, melainkan untuk menemukan celah sebelum pihak jahat menemukannya lebih dulu.
Red-teaming AI menerapkan prinsip yang sama pada model kecerdasan buatan. Para penguji mencoba berbagai cara untuk membuat model berperilaku di luar batas yang diharapkan. Mereka bisa memberikan instruksi yang menyesatkan, menyisipkan perintah tersembunyi, atau memanfaatkan celah logika. Setiap keberhasilan serangan dicatat sebagai temuan berharga bagi pengembang.
Perbedaan dengan Pengujian Biasa
Pengujian perangkat lunak biasa umumnya memeriksa apakah fitur bekerja sesuai spesifikasi. Sebaliknya, red-teaming AI berfokus pada skenario terburuk yang mungkin terjadi. Penguji berpikir seperti penyerang yang kreatif dan gigih. Mereka tidak sekadar mengikuti daftar periksa, tetapi terus mencari pendekatan baru yang belum terpikirkan.
Model bahasa besar memiliki ruang masukan yang hampir tidak terbatas. Setiap kalimat dalam bahasa alami dapat menjadi potensi serangan. Oleh karena itu, pengujian otomatis saja tidak cukup untuk menemukan semua celah. Kreativitas manusia tetap dibutuhkan untuk menemukan pola serangan yang tidak terduga.
Mengapa Format Kompetisi Efektif?
Format kompetisi mengumpulkan ratusan peserta dengan latar belakang dan gaya berpikir berbeda. Keragaman ini menghasilkan variasi serangan yang jauh lebih luas dibandingkan tim internal. Selain itu, insentif kompetisi mendorong peserta untuk terus berinovasi. Hasilnya, pengembang memperoleh data serangan yang kaya untuk memperkuat sistem mereka.
Kompetisi red-teaming AI juga menciptakan tolok ukur yang adil antar model. Semua model diuji dalam kondisi yang sama dengan pendekatan serangan yang serupa. Dengan demikian, perbandingan tingkat keamanan dapat dilakukan secara lebih objektif. Data seperti inilah yang menjadi dasar penelitian CAISI dan mitranya.
Ancaman Injeksi Prompt Tidak Langsung pada Agen AI
Agen AI berbeda dengan chatbot sederhana yang hanya menjawab pertanyaan. Agen dapat membaca dokumen, membuka situs web, mengirim email, hingga menjalankan kode. Kemampuan ini membuat agen sangat berguna untuk mengotomatisasi pekerjaan. Namun, kemampuan yang sama juga memperluas permukaan serangan secara signifikan.
Pada injeksi prompt langsung, penyerang mengetikkan instruksi berbahaya secara langsung ke model. Sementara itu, injeksi prompt tidak langsung bekerja dengan cara yang lebih tersembunyi. Penyerang menanamkan instruksi di dalam konten yang kelak dibaca oleh agen. Konten tersebut bisa berupa halaman web, isi email, komentar kode, atau dokumen bersama.

Cara Kerja Serangan
Bayangkan seorang pengguna meminta agen AI untuk merangkum kotak masuk email. Salah satu email ternyata berisi teks tersembunyi yang memerintahkan agen meneruskan data rahasia. Jika agen tidak mampu membedakan instruksi pengguna dan isi data, perintah itu bisa dijalankan. Pengguna bahkan mungkin tidak menyadari bahwa kebocoran telah terjadi.
Skenario serupa dapat terjadi saat agen menjelajahi situs web atau membaca repositori kode. Instruksi berbahaya bisa disamarkan dalam teks berwarna putih, metadata, atau komentar yang tampak tidak penting. Pasalnya, model membaca seluruh teks tanpa memandang tampilan visualnya. Inilah alasan injeksi prompt tidak langsung dianggap sebagai salah satu ancaman paling serius.
Dampak bagi Organisasi
Dampak serangan ini bisa sangat luas bagi organisasi. Data pelanggan dapat bocor, sistem internal dapat disusupi, dan reputasi perusahaan dapat rusak. Selain itu, tindakan agen yang dibajak sering kali sulit dilacak. Oleh karena itu, pengujian melalui red-teaming AI menjadi langkah pencegahan yang sangat penting.
Strategi Pertahanan Berlapis
Para ahli keamanan merekomendasikan pendekatan pertahanan berlapis untuk menghadapi ancaman ini. Lapisan pertama adalah memisahkan instruksi pengguna dengan konten eksternal secara tegas. Lapisan kedua adalah membatasi hak akses agen hanya pada fungsi yang benar-benar dibutuhkan. Lapisan ketiga adalah meminta konfirmasi manusia sebelum agen melakukan tindakan sensitif.
Selain itu, sistem pemantauan perlu mencatat setiap tindakan yang dilakukan agen. Catatan ini membantu tim keamanan mendeteksi perilaku janggal dengan cepat. Jika terjadi insiden, jejak aktivitas juga memudahkan proses investigasi dan pemulihan. Tidak ada satu lapisan pun yang sempurna, tetapi kombinasi beberapa lapisan dapat menekan risiko secara signifikan.
Jenis Serangan yang Umum Diuji dalam Red-Teaming AI
Serangan terhadap model AI hadir dalam banyak bentuk. Memahami jenis-jenisnya membantu organisasi menyusun strategi pengujian yang lebih lengkap. Berikut beberapa kategori serangan yang sering muncul dalam red-teaming AI.
Jailbreak
Jailbreak adalah upaya membuat model mengabaikan aturan keamanan yang telah ditetapkan pengembang. Penyerang biasanya menggunakan permainan peran, skenario fiksi, atau rangkaian pertanyaan bertahap. Tujuannya agar model memberikan jawaban yang seharusnya ditolak. Teknik ini terus berevolusi seiring munculnya pertahanan baru.
Kebocoran Instruksi Sistem
Banyak aplikasi AI memiliki instruksi sistem yang mengatur perilaku model. Instruksi ini sering memuat logika bisnis atau informasi internal. Penyerang dapat mencoba memancing model agar mengungkapkan isi instruksi tersebut. Kebocoran semacam ini membuka peluang serangan lanjutan yang lebih terarah.
Penyalahgunaan Alat dan Integrasi
Agen AI modern dapat memanggil alat seperti pengirim email, basis data, atau eksekutor kode. Penyerang berusaha membuat agen memanggil alat tersebut untuk tujuan berbahaya. Contohnya adalah mengirim data ke alamat asing atau menghapus berkas penting. Kategori ini menjadi fokus utama red-teaming AI pada pembajakan agen.
Manipulasi Bertahap dalam Percakapan Panjang
Sebagian serangan tidak dilakukan dalam satu pesan, melainkan melalui percakapan panjang. Penyerang membangun konteks sedikit demi sedikit hingga model kehilangan batasannya. Pendekatan ini sulit dideteksi oleh filter yang hanya memeriksa pesan tunggal. Oleh karena itu, pengujian perlu mencakup interaksi multi-langkah.
Benchmarking Red-Teaming AI: Tantangan dan Temuan
Setahun yang lalu, CAISI mempublikasikan upayanya dalam menyempurnakan metode evaluasi terhadap serangan pembajakan agen. Penilaian terbaru terhadap model DeepSeek menunjukkan bahwa sistem ini lebih rentan terhadap serangan pembajakan dibandingkan model terkemuka dari Amerika Serikat. Contoh kasus melibatkan manipulasi model DeepSeek untuk mengirim email phishing, menjalankan malware, serta mengekstraksi kredensial pengguna.
Kompetisi red-teaming AI berperan penting dalam menjembatani kesenjangan keamanan. Caranya adalah dengan mengundang peserta untuk menguji model dan sistem pertahanan secara langsung. Dalam kompetisi terbaru, lebih dari 400 peserta melakukan lebih dari 250.000 upaya serangan terhadap 13 model AI terkini. Hasilnya, setiap model berhasil ditembus setidaknya satu kali, mengungkapkan tantangan besar dalam mengamankan agen AI. Namun, penelitian juga menemukan variasi signifikan dalam jumlah serangan yang berhasil di antara model. Variasi tersebut tidak memiliki korelasi konsisten dengan kemampuan model. Temuan ini menyoroti pentingnya benchmarking keamanan komparatif untuk menilai risiko berbagai sistem AI.
7 Wawasan Penting dari Kompetisi Red-Teaming AI
Hasil kompetisi ini memberikan banyak pelajaran bagi pengembang, peneliti, dan pengguna teknologi AI. Berikut tujuh wawasan utama yang dapat dipetik dari penelitian red-teaming AI tersebut.
1. Tidak Ada Model yang Sepenuhnya Kebal
Setiap model yang diuji berhasil ditembus setidaknya satu kali. Fakta ini menunjukkan bahwa keamanan sempurna belum dapat dicapai. Oleh karena itu, organisasi perlu menerapkan lapisan perlindungan tambahan. Mengandalkan keamanan bawaan model saja merupakan strategi yang berisiko.
2. Kemampuan Tinggi Tidak Menjamin Keamanan
Penelitian tidak menemukan korelasi konsisten antara kemampuan model dan ketahanannya. Model yang lebih cerdas belum tentu lebih aman dari serangan. Dengan demikian, pemilihan model sebaiknya mempertimbangkan hasil uji keamanan secara terpisah. Skor kecerdasan di papan peringkat tidak cukup sebagai acuan.
3. Serangan Universal Itu Nyata
Beberapa keluarga serangan mampu bekerja di berbagai model sekaligus. Serangan ini memanfaatkan kelemahan bersama dalam cara model mengikuti instruksi. Artinya, satu teknik serangan bisa mengancam banyak sistem dalam waktu bersamaan. Pengembang perlu memperhatikan pola kelemahan bersama ini secara serius.
4. Serangan dari Model Kuat Mudah Ditransfer
Serangan yang dirancang untuk model kuat cenderung berhasil pada model yang kurang aman. Temuan ini memberi petunjuk penting bagi strategi pengujian. Sebagai contoh, tim keamanan dapat menguji serangan terhadap model terkuat terlebih dahulu. Setelah itu, serangan yang berhasil dapat digunakan untuk mengevaluasi model lain.
5. Keragaman Penyerang Menghasilkan Temuan Lebih Kaya
Ratusan peserta dengan gaya berbeda menghasilkan ratusan ribu variasi serangan. Jumlah dan keragaman ini sulit ditandingi oleh tim internal yang kecil. Oleh karena itu, kolaborasi terbuka menjadi aset berharga dalam red-teaming AI. Pendekatan komunitas mempercepat penemuan celah yang tersembunyi.
6. Benchmark Komparatif Sangat Dibutuhkan
Variasi tingkat keberhasilan serangan antar model sangat signifikan. Tanpa tolok ukur yang seragam, organisasi sulit menilai risiko secara objektif. Benchmark komparatif membantu pengambil keputusan memilih sistem yang paling sesuai. Selain itu, benchmark mendorong pengembang untuk terus memperbaiki keamanan produknya.
7. Keamanan Adalah Proses Berkelanjutan
Teknik serangan terus berkembang seiring kemajuan model AI. Pertahanan yang efektif hari ini belum tentu efektif besok. Karena itu, pengujian keamanan harus dilakukan secara rutin dan berulang. Red-teaming AI sebaiknya menjadi bagian tetap dari siklus pengembangan produk.
Kolaborasi Red-Teaming AI untuk Masa Depan Keamanan
Penelitian ini juga mengeksplorasi transferabilitas serangan yang dikembangkan selama kompetisi ke model dan skenario lainnya. Beberapa keluarga serangan “universal” berhasil diidentifikasi. Serangan ini mampu mengeksploitasi kelemahan bersama dalam perilaku mengikuti instruksi di berbagai model. Secara khusus, serangan yang dirancang terhadap model yang lebih kuat lebih mungkin ditransfer ke model yang kurang aman. Hal ini mengungkapkan kerentanan kritis dalam sistem AI.
Kompetisi red-teaming AI memainkan peran penting dalam memajukan keamanan AI. Sebagai bagian dari kolaborasinya dengan Gray Swan, CAISI berkontribusi pada pengembangan metodologi analisis. CAISI juga mendapatkan akses ke data kompetisi, termasuk strategi serangan yang diajukan oleh peserta. Informasi ini akan menjadi panduan dalam desain kompetisi red-teaming di masa depan serta meningkatkan kerangka evaluasi keamanan CAISI.
Keamanan AI tetap menjadi tantangan yang terus berkembang dan menghadirkan berbagai hambatan. Hambatan tersebut antara lain navigasi lanskap luas potensi serangan berbasis bahasa alami dan memahami transferabilitas serangan di berbagai model. CAISI berkomitmen untuk bekerja sama dengan organisasi seperti Gray Swan, evaluator independen, dan pengembang AI terkini. Kerja sama ini bertujuan menciptakan alat, metodologi, serta praktik yang mampu mengatasi tantangan ini. Upaya ini bertujuan untuk memastikan agen AI dapat diterapkan dengan aman dalam aplikasi bernilai ekonomi tinggi. Dalam aplikasi seperti itu, keamanan yang kuat sangat diperlukan.
Peran Red-Teaming AI bagi Bisnis di Indonesia
Penerapan AI di Indonesia terus meningkat di berbagai sektor. Perbankan, ritel, layanan publik, hingga pendidikan mulai memanfaatkan asisten virtual dan agen otomatis. Banyak perusahaan menggunakan chatbot AI untuk melayani pelanggan selama 24 jam. Seiring adopsi ini, kebutuhan akan sistem yang aman dan tepercaya juga semakin mendesak.
Melindungi Layanan Pelanggan
Asisten virtual sering memiliki akses ke data pelanggan, riwayat transaksi, dan sistem internal. Jika asisten tersebut dapat dimanipulasi, dampaknya bisa merugikan pelanggan dan perusahaan. Melalui red-teaming AI, bisnis dapat mengetahui seberapa mudah asisten mereka dibajak. Temuan ini kemudian digunakan untuk memperketat aturan dan batasan akses.
Tantangan menjadi lebih kompleks ketika layanan berjalan di banyak kanal sekaligus. Perusahaan yang menerapkan layanan omnichannel AI menerima pesan dari WhatsApp, media sosial, situs web, dan email. Setiap kanal membawa jenis konten dan risiko yang berbeda. Red-teaming AI perlu mencakup seluruh kanal agar tidak ada celah yang terlewat.
Membangun Kepercayaan Pengguna
Kepercayaan pelanggan merupakan aset yang sulit dibangun dan mudah hilang. Satu insiden kebocoran data dapat merusak reputasi yang dibangun selama bertahun-tahun. Sebaliknya, komitmen terhadap keamanan dapat menjadi keunggulan kompetitif. Pelanggan cenderung memilih layanan yang terbukti menjaga data mereka dengan baik.
Selain itu, regulasi perlindungan data pribadi di Indonesia menuntut perusahaan bertanggung jawab atas data pelanggan. Pengujian keamanan yang rutin membantu perusahaan memenuhi kewajiban tersebut. Dengan demikian, red-teaming AI tidak hanya bermanfaat secara teknis, tetapi juga secara hukum dan bisnis.
Tantangan Red-Teaming AI dalam Konteks Bahasa Indonesia
Sebagian besar penelitian keamanan AI masih berfokus pada bahasa Inggris. Padahal, model AI kini digunakan secara luas oleh penutur bahasa Indonesia. Perbedaan bahasa dapat memunculkan celah yang tidak terdeteksi dalam pengujian berbahasa Inggris. Inilah tantangan khusus yang perlu diperhatikan oleh pengembang lokal.
Bahasa Indonesia memiliki ragam formal, ragam santai, serta bahasa gaul yang terus berubah. Selain itu, masyarakat sering mencampur bahasa Indonesia dengan bahasa Inggris atau bahasa daerah. Variasi ini dapat dimanfaatkan penyerang untuk mengelabui filter keamanan. Filter yang hanya dilatih dengan kalimat baku bisa gagal mengenali instruksi berbahaya.
Oleh karena itu, red-teaming AI untuk pasar Indonesia perlu menggunakan data dan skenario lokal. Penguji sebaiknya memahami budaya, kebiasaan berbahasa, dan konteks bisnis setempat. Dengan pendekatan ini, celah yang spesifik terhadap bahasa dan budaya dapat ditemukan lebih awal.
Langkah Praktis Menerapkan Red-Teaming AI
Organisasi tidak harus menunggu kompetisi besar untuk mulai menguji sistem AI mereka. Pengujian sederhana dapat dimulai dari skala kecil dan dikembangkan secara bertahap. Berikut beberapa langkah praktis yang dapat dipertimbangkan.
Petakan Aset dan Hak Akses
Langkah pertama adalah memahami apa saja yang dapat diakses oleh agen AI. Catat sumber data, alat, dan tindakan yang diizinkan untuk agen tersebut. Semakin luas aksesnya, semakin besar pula risiko yang perlu diuji melalui red-teaming AI. Prinsip hak akses minimum sebaiknya diterapkan sejak awal.
Rancang Skenario Serangan
Selanjutnya, susun daftar skenario serangan yang relevan dengan bisnis Anda. Sertakan upaya injeksi prompt langsung maupun tidak langsung. Uji juga permintaan yang mencoba membocorkan data, mengubah perilaku, atau melewati aturan. Gunakan bahasa Indonesia dan bahasa daerah karena celah bisa muncul dari variasi bahasa.
Libatkan Tim yang Beragam
Ajak anggota tim dari berbagai divisi untuk ikut menguji sistem. Staf layanan pelanggan, tim teknis, dan tim hukum memiliki sudut pandang berbeda. Keragaman ini meniru keunggulan format kompetisi dalam skala lebih kecil. Hasilnya, temuan yang diperoleh menjadi lebih lengkap dan realistis.
Dokumentasikan dan Perbaiki
Setiap serangan yang berhasil harus didokumentasikan secara rinci. Catat masukan yang digunakan, perilaku model, dan dampak yang ditimbulkan. Setelah itu, terapkan perbaikan berupa filter, batasan akses, atau penyesuaian instruksi sistem. Uji ulang untuk memastikan perbaikan benar-benar efektif.
Lakukan Secara Berkala
Ulangi pengujian setiap kali ada pembaruan model, fitur, atau integrasi baru. Perubahan kecil dapat membuka celah yang sebelumnya tidak ada. Jadwalkan sesi red-teaming AI secara rutin, misalnya setiap kuartal. Dengan cara ini, keamanan sistem terus terjaga seiring perkembangan teknologi.
Pertanyaan Umum seputar Red-Teaming AI
Siapa yang Dapat Melakukan Red-Teaming?
Red-teaming AI dapat dilakukan oleh tim keamanan internal, konsultan eksternal, maupun komunitas terbuka. Kompetisi seperti yang diselenggarakan Gray Swan melibatkan peserta umum dari berbagai latar belakang. Yang terpenting adalah kemampuan berpikir kreatif seperti seorang penyerang.
Apakah Red-Teaming Berbahaya bagi Sistem?
Pengujian sebaiknya dilakukan di lingkungan uji yang terpisah dari sistem produksi. Dengan begitu, serangan yang berhasil tidak menimbulkan kerugian nyata. Temuan dari lingkungan uji kemudian digunakan untuk memperbaiki sistem yang sebenarnya.
Seberapa Sering Pengujian Perlu Dilakukan?
Tidak ada aturan baku, tetapi pengujian ideal dilakukan setiap ada perubahan signifikan. Perubahan tersebut meliputi pembaruan model, penambahan fitur, atau integrasi alat baru. Program red-teaming AI yang rutin memastikan sistem tetap tangguh menghadapi teknik serangan terbaru.
Kesimpulan: Red-Teaming AI sebagai Fondasi Kepercayaan
Penelitian CAISI bersama Gray Swan dan para mitranya menunjukkan bahwa keamanan agen AI masih menghadapi tantangan besar. Setiap model yang diuji dapat ditembus, dan serangan universal mampu menjangkau banyak sistem sekaligus. Namun, temuan ini justru membuka jalan bagi perbaikan yang lebih terarah. Data dari kompetisi memberikan peta kerentanan yang sangat berharga bagi pengembang.
Bagi bisnis, pelajaran utamanya jelas: keamanan AI harus diuji secara aktif dan berkelanjutan. Menerapkan red-teaming AI membantu organisasi menemukan celah sebelum dimanfaatkan pihak jahat. Pada akhirnya, sistem yang aman akan membangun kepercayaan pelanggan dan mendukung pertumbuhan bisnis jangka panjang.